用户问:“DEMO-Q2 的最高采样速率是多少?”检索结果里有这个系列的手册,回答还附了引用,却把单通道的数字当成了双通道的数字。再追问一次,模型又从另一份资料里找出一个不同答案。
这种情况很容易被归结为“模型不够聪明”。但沿着证据往前看,问题可能发生在三个不同位置:相关行没被召回,表格结构在解析时丢了,或者答案混用了不同条件下的数据。它们需要分别处理。
下面用一份完全虚构的采集模块手册说明这个过程。型号、版本、温度和数值均为教学演示,不能用于选型。
引用了一份手册,还不等于引用对了那一格
假设手册规定,型号 DEMO-Q2 属于 DEMO-Q 系列,末尾的 2 表示双通道。正文中的表格没有重复完整型号:
| 资料 | 系列 | 通道数 | 环境条件 | 最高采样速率 |
|---|---|---|---|---|
| 演示手册 B 版 | DEMO-Q | 1 | 0~30 ℃ | 140 kS/s |
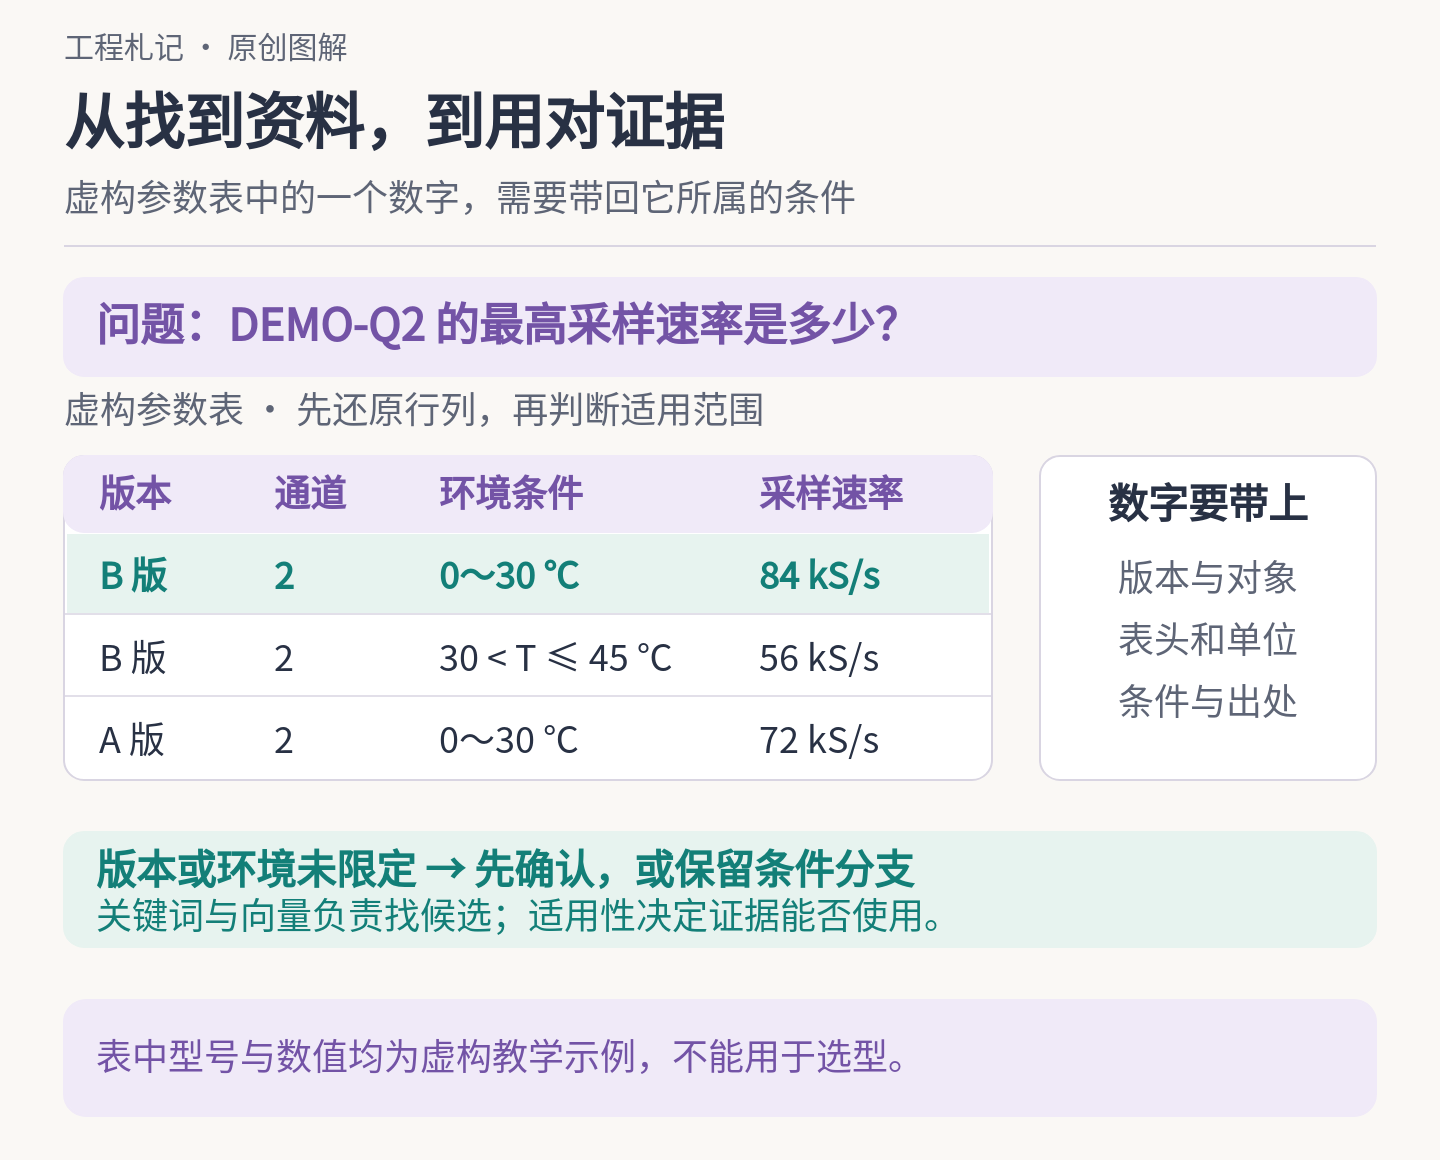
| 演示手册 B 版 | DEMO-Q | 2 | 0~30 ℃ | 84 kS/s |
| 演示手册 B 版 | DEMO-Q | 2 | 大于 30 ℃、不超过 45 ℃ | 56 kS/s |
| 演示手册 A 版 | DEMO-Q | 2 | 0~30 ℃ | 72 kS/s |
搜索完整字符串 DEMO-Q2,可能只找到封面上的产品列表。正文真正包含答案的地方写的是 DEMO-Q,通道数藏在另一列。向量检索也可能把几行都找出来,但最高分不保证对应正确通道。
假设用户已经确认使用 B 版,一个有用的回答应承认问题还缺环境条件:“按演示手册 B 版,双通道在 0~30 ℃时为 84 kS/s,在另一温度范围内为 56 kS/s。你需要哪个工况?”如果用户指定 A 版,就应按 A 版回答,不能因为 B 版看起来更新而自行替换。
这里要保住的是型号、指标、条件和版本之间的关系。只有一个数字和一个文档链接,读者仍然无法复核。
给精确标识和自然语言各留一条召回路径
型号、条款号、产品编号具有明显的词法特征;“高温时速度会不会下降”则更依赖语义。实际检索可以同时使用关键词路径和向量路径,再合并候选。Azure AI Search 的混合检索说明介绍了这种组合,以及用 RRF 融合排名的一种实现。
对于例子中的型号,可以保留完整写法,并在明确的命名规则下增加系列写法。扩展结果只获得“进入候选池”的资格。DEMO-Q2 不能靠子串命中 DEMO-Q20;也不能凭任何型号最后一位是数字,就猜它一定表示通道数。
还要保留扩展依据。若命名规则来自手册,就让规则本身成为可引用证据;若规则尚未核实,就把系列行作为待确认候选,避免在检索阶段提前替用户做业务判断。
元数据检索也有用途:标题命中了某份手册,下一步应在这份手册里补召回相关正文。否则重复出现的封面、目录和前言可能占满候选名额,而真正的参数表始终进不了答案上下文。
把一格数值还原成一条完整证据
表格切成文本后,单元格可能离开表头,单位可能在标题里,例外条件则在表尾脚注。把“84”交给模型,即使检索排名很高,也提供不了足够的判断依据。
应尽量保留行列位置、表头、单位、表题和相关脚注,再围绕命中单元格组织上下文。Document Intelligence 的布局分析文档展示了表格、表头和结构信息的提取能力;采用其他解析器时,也可以用这些信息检查输出是否够用。
下面是从虚构表格整理出的证据示例。这是说明信息关系的格式,不要求检索系统采用同一套字段:
{
"source_id": "E1",
"document": "演示采集模块手册 B 版",
"section": "采样性能表",
"series": "DEMO-Q",
"channels": 2,
"temperature": "0~30 ℃",
"metric": "最高采样速率",
"value": 84,
"unit": "kS/s"
}
真实系统还应能从这条证据定位回原文件的页码、表格或原文片段。如果解析器连表头都没有识别出来,邻接扩展可能补回附近文本,却不能保证恢复丢失的行列关系。此时应重新解析、核对原页,或明确说明证据不足。
先限定能用的资料,再比较哪条更相关
精排可以改善候选顺序。Azure 的语义排序文档明确把它放在初次检索之后:它处理已经进入候选集的内容。因此,关键表格没有召回时,提高精排能力也补不回那张表。
同样,相关分数不能代替适用范围。用户指定“双通道、普通环境、A 版”,这三个条件应约束证据选择。单通道的一条高分结果、另一温度范围的清晰表格、标题更完整的 B 版,都不能直接覆盖这些限定。
可以按这样的顺序组织回答:先确认对象和指标,再核对用户指定的版本与条件;将可比较的证据放在一起,最后生成答案。条件缺失时保留分支,条件冲突时指出冲突。只有证据适用性相当时,资料类型和排序分数才适合帮助确定展示顺序。
文件名中的年份只是版本线索。没有核查发布机构的现行目录,就不要把“文件比较新”写成“这是现行有效标准”。
用一张小表,检验整条链路
检验这套做法时,可以直接使用上面的虚构资料,准备几道答案明确的问题:
| 问法或干扰 | 应观察的结果 |
|---|---|
| 问完整型号,正文只有系列名 | 找到系列行,并结合通道列 |
| 同时放入相似型号 | 不把前缀相同当成同一对象 |
| 不指定环境条件 | 说明条件差异或追问,避免硬选一个数 |
| 明确指定 A 版 | 使用指定版本,不擅自升级 |
| 删除表头或单位 | 暴露证据缺口,避免猜测补全 |
| 添加高分封面片段 | 参数正文仍有机会进入候选 |
检查时分开记录“召回到了吗”“选对单元格了吗”“回答保留条件了吗”。只看最终答案的正确率,很难判断下一步该改解析、检索还是生成。
延迟也要按实际链路测量:查询向量化、检索、精排和生成各占多少时间。测量时固定资料集、问题集和各阶段配置,分别记录耗时;只比较一次模型请求的用时,无法判断整条问答链路快了多少。
当答案写出“84 kS/s”时,最有价值的追问是:这个数字来自哪一格,属于哪个对象,在什么条件下成立?检索系统能把这几个问题一起回答清楚,引用才真正成为证据。
本文的回复通知
只在有人回复你发表于本文的评论时通知你。
登录后设置。