想体验前沿 AI 模型,又不想一开始就分别订阅好几个产品,可以先打开 Arena。它提供免费的模型体验与对比入口,最有意思的玩法是 Battle 盲测:把同一道题交给两个匿名模型,先判断回答,再揭晓名字。有时你还会遇到以代号出现、正在接受社区测试的新模型。
Arena 曾叫 LMArena,更早以 Chatbot Arena 为人熟知。它把真实用户的比较与投票汇集成榜单,也让普通人有机会亲手试一试新模型。对创作者而言,它适合用来发现工具、比较风格,建立自己的选择依据。
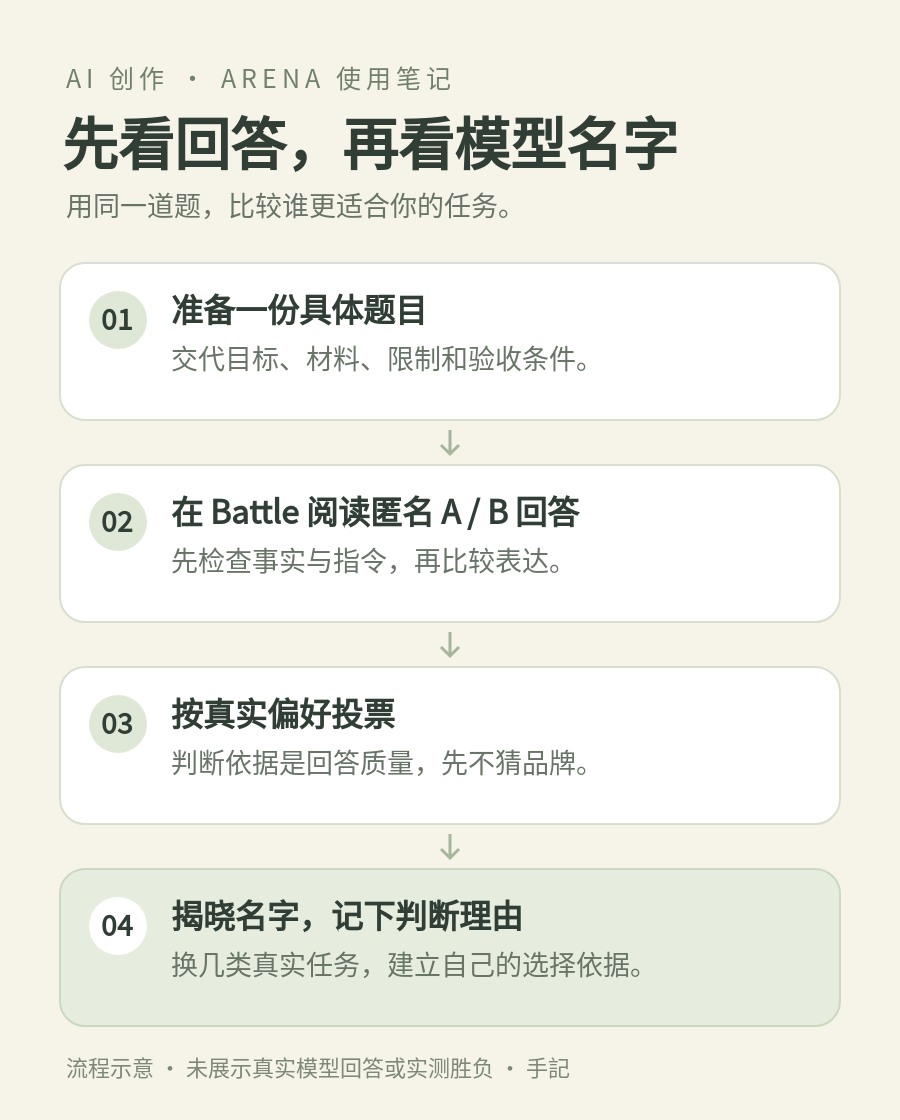
一条提示词,两份匿名回答
进入 Arena 后,选择适合任务的入口,再使用 Battle 模式。输入提示词,等左右两份回答完成;在模型名字揭晓之前,比较它们是否满足需求,然后投票。官方说明,名字在投票后揭示,匿名阶段的有效投票才会影响公开榜单。
第一次使用可以按这四步走:
- 写具体任务。 给出材料、读者、输出形式和限制,让两个模型面对同一道题。
- 完整读完两份回答。 先检查事实与要求,再看表达;不要只因为答案长、排版漂亮就选它。
- 按本轮表现投票。 写下一句理由,例如“保留了全部费用信息,而且没有新增承诺”。
- 揭晓后记下模型。 换几类自己常做的任务继续比较,不凭一局就认定某个模型最好。
投票后继续交互时,注意界面显示的模型和对局变化。官方 FAQ 提醒,新一轮可能重新抽样模型,切换对局时上下文也不一定沿用;不要把整段聊天都当作同一组固定对照。
几个常见模式可以这样区分:
| 模式 | 适合做什么 | 模型身份与榜单 |
|---|---|---|
| Battle | 发现自己偏好的回答,减少品牌预期影响 | 匿名比较、投票后揭晓;有效匿名票影响榜单 |
| Side by Side | 对比已经选好的两个模型 | 预先知道身份;投票不计入公开榜单 |
| Direct | 单独体验一个已开放的模型 | 没有双模型投票 |
这些入口的模型列表会变化。榜单里出现某个名字,也不代表它此刻能在每种模式中手动选择。
免费体验的边界要看清
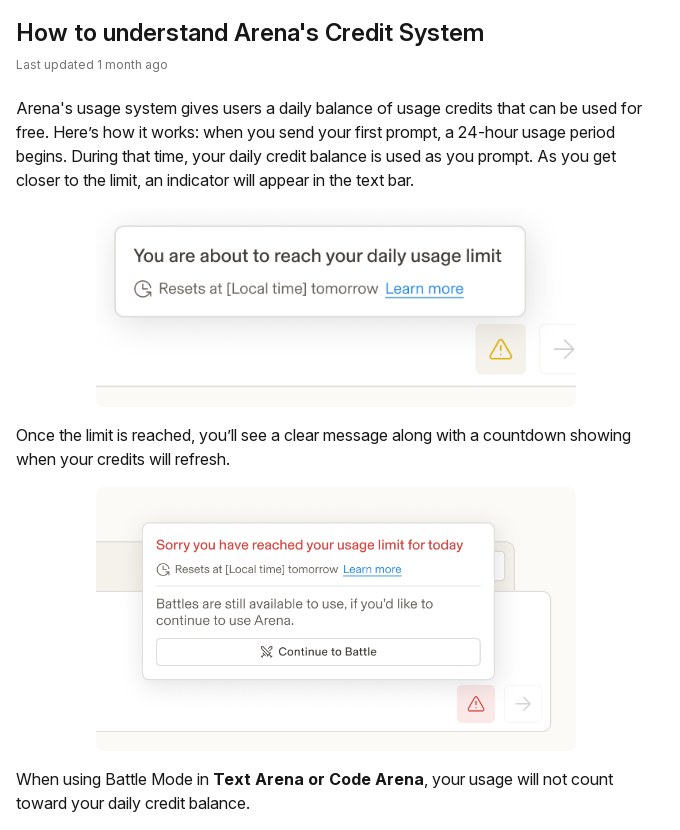
截至 2026 年 11 月 6 日查阅的官方额度说明,Arena 提供每天可免费使用的 credits:从发出第一条提示词开始计算一个 24 小时使用周期,接近上限时显示提示,用完后显示刷新倒计时。Text Arena 和 Code Arena 的 Battle 模式不计入这份每日 credits。
这让它很适合先试再选。不过,“不扣每日额度”不等于没有任何限制:官方另有按模型及整体聊天频率设置的限流,繁忙时也可能暂时不可用。额度、开放模型和功能以当时界面与官方说明为准,不应理解成所有最新模型随时无限免费。
遇到代号模型时,可以照常评价回答,但不要根据口吻猜测厂商并当成事实传播。官方 FAQ 说明,部分预发布模型会用别名参与测试;通过相应发布与榜单要求后,才可能以正式名字进入公开排名。能提前体验是一种机会,并非每轮都保证抽中尚未发布的模型。
带一道能分出差别的题去试
“写一篇好文章”太宽泛,很容易只比出谁更会铺陈。把任务变成可核查的要求,差别会更清楚。下面沿用本专栏的咖啡馆案例;门店和活动均为虚构教学设定,这是一道待使用的比较题,不是模型实测记录。
请根据以下材料,写一则适合发到邻里群的活动通知。
门店:窗边咖啡馆(虚构教学案例)
活动:手冲演示与风味交流
时间:[活动日期] 14:00—16:00
地点:[门店地址]
人数:最多12人
费用:每人39元,含一杯手冲
参与:通过[预约方式]联系,收到确认才算预约成功
没有赠品、免费续杯或额外折扣;取消退款规则尚未确认。
要求:
1. 正文约180字,分成适合手机阅读的短段。
2. 必须保留时间、地点、人数、费用和预约确认规则。
3. 方括号占位保持原样,不编造优惠、地址或讲师资历。
4. 末尾另列正式发布前需确认的事项,不自行补写退款规则。
在发送前先定标准,可以避免看完结果后临时换标准“偏心”。这道题可用下面四项检查:
| 检查项 | 具体看什么 |
|---|---|
| 事实准确 | 39 元、12 人、含一杯手冲有没有写错,有没有新增承诺 |
| 指令遵循 | 占位是否保留,通知与待确认事项是否分开 |
| 信息完整 | 时间地点、活动内容、费用和预约方法是否容易找到 |
| 阅读体验 | 句子是否清楚,手机上是否便于快速扫描 |
如果一份回答很动人,却擅自加上“免费续杯”,事实错误应优先于文采。如果两份都合格,就比较哪份更少需要你修改。再换一个任务测试,例如把一段长文压成三条摘要,或按明确字段输出表格,观察同一模型在不同要求下是否稳定。
自己的记录可以很轻量:日期、任务类型、提示词版本、揭晓的模型、选择理由。不要只记“某模型赢了”,要记“它保留了哪个关键限制”。以后真正选工具时,这些理由比一张总榜截图更有用。
看榜单时,多看两列
Arena 的常规偏好榜单根据用户的成对比较,用 Bradley–Terry 等统计方法估计表现。它反映的是相应样本和任务下的人类偏好,不能直接等同于每道题的正确率。
打开 榜单 后,先选与工作相近的类别:写作看 Text,代码看 Code,读图看 Vision;需要时再查看类别筛选。接着看 Votes 与 Score 的置信区间。比较票数少、区间较宽的模型,排名仍有较大不确定性;相邻名次也未必存在明确差距。Rank Spread 展示可能的名次范围,值得一起看。
官方榜单指南中的 Price $/M 表示每百万 Token 的输入、输出价格信息,不能把它当作你在 Arena 本轮试用的账单。做长期选型时,还要回到目标产品核对价格、速度、上下文和功能是否满足需求。
把体验变成自己的工作方法
先用两三类常做的任务发现喜欢的模型,再把真实作品放到适合持续编辑的工具里完成。例如在 Arena 比较文案方向后,可以按创作简报整理需求,再到 Whatsblog AI Studio推进页面或项目。跨平台迁移时自己保存材料与判断依据,不能假定聊天会自动同步。
还要留意,Arena 官方说明对话可能用于评测、研究及与模型提供方的相关共享。练习时使用公开材料或脱敏后的虚构样例,别把客户名单、账号凭据或未公开文档直接粘进去。
免费体验前沿模型的价值,在于亲手判断它是否适合自己的任务。带着具体题目去、带着明确理由回来,比围着某个名字站队更能帮助下一次创作。
官方资料
以下页面查阅于 2026 年 11 月 6 日;本文基于官方公开说明整理,未进行模型生成或胜负实测。
- Arena:How It Works 与 FAQ:匿名比较、投票揭示、各模式及预发布模型说明。
- Arena Credit System:每日免费 credits、24 小时周期和 Battle 额度规则。
- Arena:Rate Limit:模型与整体聊天频率限制。
- Arena:Leaderboard Guide:榜单类别、Votes、置信区间与价格列。
- Arena:Models May Be Removed:可选模型的开放范围会调整。
本文的回复通知
只在有人回复你发表于本文的评论时通知你。
登录后设置。